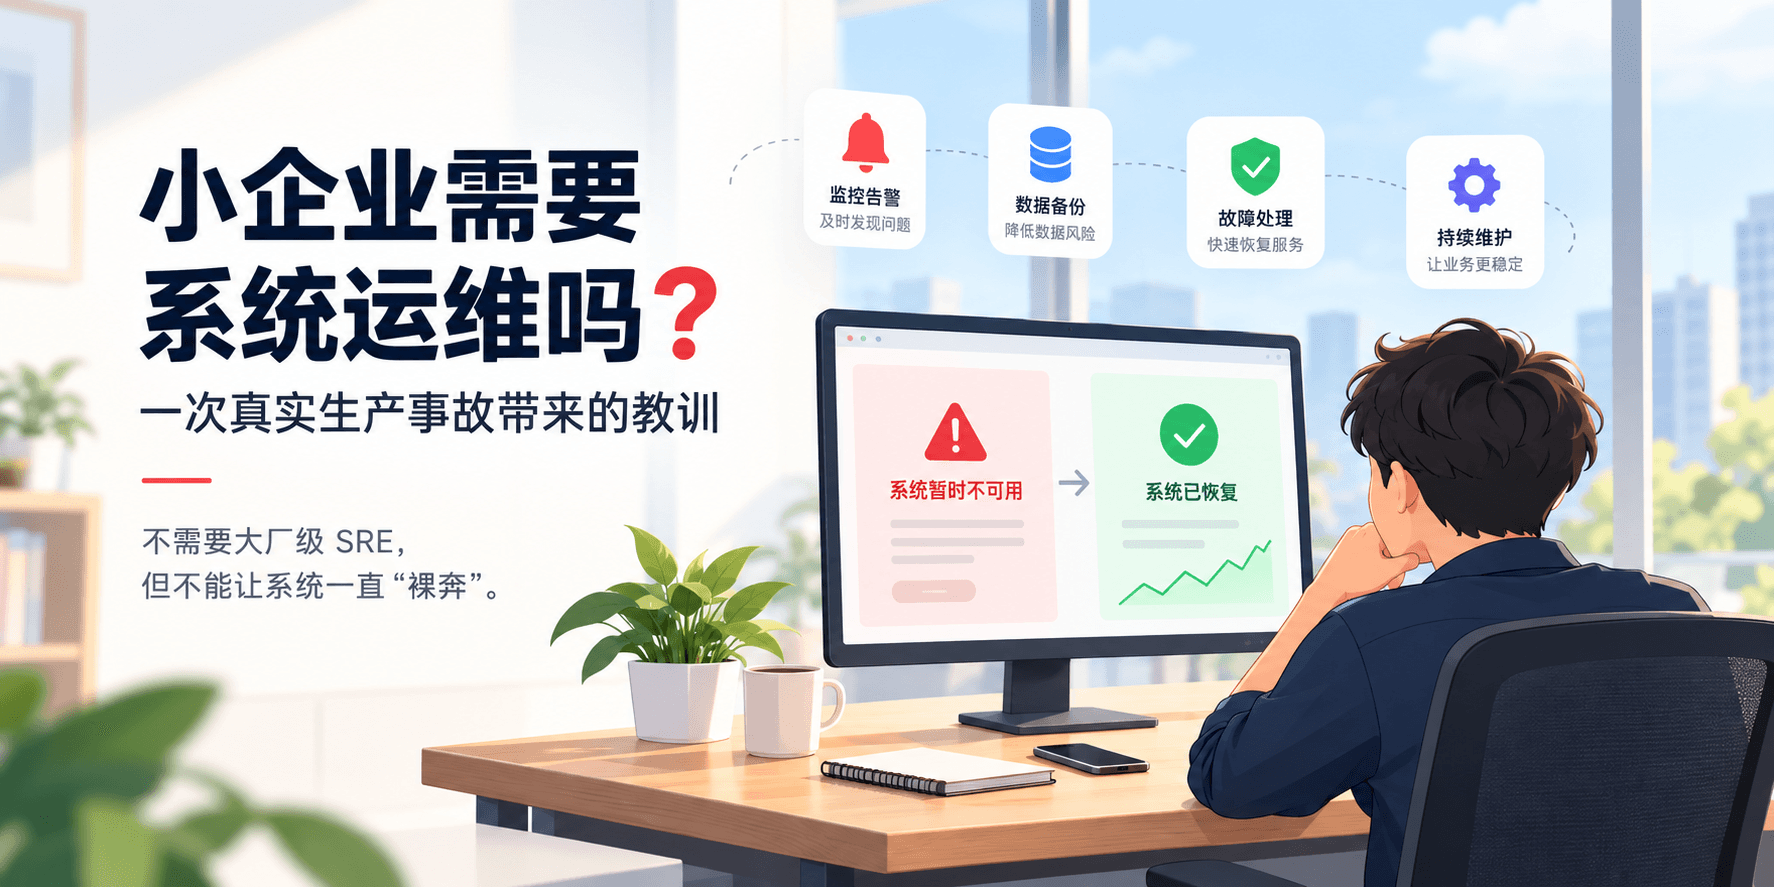
对于很多小企业老板来说,“系统运维”听起来很容易和大型互联网公司联系在一起。服务器集群、7×24 小时值班、几十块监控大屏、专门的 SRE 团队……如果自己的系统每天可能只有几十、几百个用户,很自然会产生一个疑问:我们有必要搞这些吗?
甚至当系统真的出现一次故障时,很多人的第一反应也是:“不就是挂了一会儿吗?我们又不是银行,几分钟能损失多少钱?”这个问题其实非常合理。
小企业当然没有必要照搬大型互联网公司的运维体系。但另一边的极端——系统上线以后完全没人管,直到客户发现坏了才开始处理——同样会带来不必要的风险。最近我们处理的一次真实生产事故,就很好地说明了这件事。
本文来自一个匿名真实项目。为了保护客户隐私,文中隐去了客户名称、具体业务和部分技术细节。
TL;DR:小企业为什么仍然需要基本运维?
- 小企业不需要“大厂级 SRE”,但至少应该知道系统什么时候开始出问题。
- 这次事故中,系统在客户发现以前,其实已经出现了一段时间的异常。
- “重启以后恢复”只能证明系统暂时又能用了,并不能证明问题已经解决。
- 一个原本局部的数据库异常,可能因为重试、后台任务和请求堆积被系统自己不断放大。
- 对客户来说,十分钟宕机的影响并不只等于“十分钟营业额损失”。
- 系统故障时,用户应该看到友好的降级页面,而不是莫名其妙的错误信息。
- 监控、告警、备份检查和事故复盘,并不一定意味着要招聘一名全职 DevOps。
- 小企业真正需要的,往往只是:系统出了问题,有人知道;出了大问题,有人负责。
“系统挂了几分钟”可能根本不是完整事实
这次事故里,客户是在晚上发现系统已经无法正常使用的。如果只从用户视角来看,很容易得出一个结论:“网站晚上突然挂了。”
但检查日志以后,我们发现异常其实更早就已经开始出现。只是因为系统没有完善的监控和告警,没有任何人在异常刚刚出现时收到通知。换句话说:系统什么时候开始坏,和老板什么时候发现它坏,可能是两个完全不同的时间。
这也是“完全没有运维”和“至少有基本监控”之间最重要的区别之一。一个系统不一定要做到永不故障,但它至少应该能够在自己开始变得不正常的时候告诉你。
重启以后好了,为什么还要继续查?
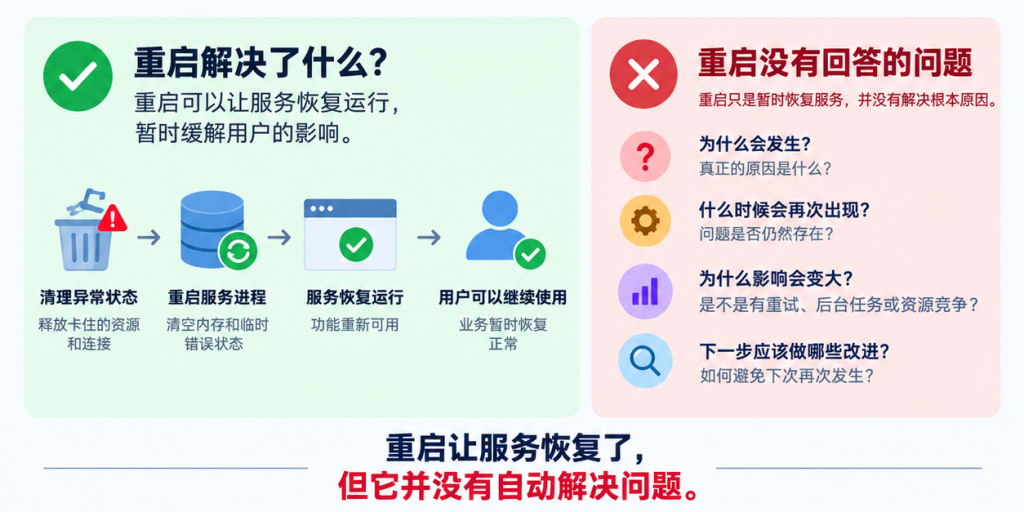
这次事故后来通过重启后端应用暂时恢复。如果这是一台家里的路由器,这件事情可能到这里就结束了:不好用 → 重启 → 好了。但生产系统不能只停留在这一步。
因为重启只回答了:“怎么暂时恢复?”它没有回答:“为什么会发生?”更没有回答:“下一次什么时候还会发生?”
如果问题来源是资源耗尽、无限重试、数据库连接竞争或者后台任务之间互相影响,那么重启只是把已经堆积的状态清空。问题本身依然存在。恢复服务和解决事故,是两件不同的事情。
一个成熟一点的运维流程,通常会先恢复业务,再继续调查原因,然后决定哪些地方需要整改。
小企业不是银行,但也有自己的“关键十分钟”
很多老板会继续问:“就算挂十分钟,我们也不会损失几百万,真的值得花这么多精力吗?”如果只计算直接营业额,这个判断可能没错。但小企业的系统风险,很多时候并不是按“每分钟损失多少钱”计算的。
举几个更加现实的场景:
| 系统故障发生时 | 用户实际感受到的事情 |
|---|---|
| 新客户第一次注册 | “这个平台是不是不靠谱?” |
| 销售正在给客户演示 | “你们自己的系统怎么打不开?” |
| 广告刚刚开始投放 | 点击进来的潜在客户无法注册 |
| 员工处理当天业务 | 后台打不开,只能暂停工作 |
| 老客户准备付款或提交资料 | 操作失败,不知道数据有没有保存 |
这些事情可能只发生十分钟。但客户并不知道:“哦,这只是一个十分钟的偶发技术事故。”客户看到的只是一个非常简单的结果:我需要使用你的系统时,它没有工作。
对于一个正在建立信誉的小企业来说,这种体验有时候比十分钟营业额本身更加昂贵。
真正麻烦的不是故障,而是系统自己把故障越搞越大
这次事故还有一个非常典型的特点。最初的问题并不是“整个网站所有东西同时坏掉”。首先出现的是数据库连接异常。
理论上,一个设计得比较稳健的系统应该能够做到:部分请求失败;暂停部分非关键任务;减少重试;等待数据库恢复;然后逐渐恢复正常业务。
但实际系统里,新的请求仍然不断进入,一些失败操作又继续尝试,后台任务和用户请求仍然在争抢有限资源。最终,一个局部故障逐渐扩大到了登录、查询、文件访问和后台任务。
这就是软件系统里经常说的级联故障(Cascading Failure)。它背后的逻辑并不复杂:一个地方已经堵车了,如果所有车辆仍然不断往里面开,堵车只会越来越严重。
所以现代软件才会有“限流”“熔断”“服务降级”这些听起来比较技术的东西。本质上,它们都是在做同一件事:当系统已经出现问题时,不要继续主动扩大问题。
“内部服务器错误”不是一个合格的故障体验
这次事故也暴露出了另外一个问题。当后端已经出现严重异常时,用户仍然可以正常打开页面、点击登录或者提交请求。然后他最终得到一个:500 内部服务器错误。
程序员看到这个词,很容易理解:“后端 500 了。”但普通用户看到它,通常只会产生更多疑问:我的密码错了吗?账号是不是坏了?资料有没有提交成功?是不是我电脑有问题?还是整个网站都坏了?
所以我们后续计划增加一层服务降级。当系统健康检查确认后端已经不可用,或者关键请求连续超时和返回错误时,前端不再反复提交无意义请求。而是直接告诉用户:系统暂时不可用,我们正在处理。请稍后再试。
这当然不能让服务器瞬间恢复。但它能把一个混乱的技术故障,变成一个受控的用户体验。对于小企业来说,这已经是非常实际的提升。
监控并不是为了做一面漂亮的大屏
另一个常见误区,是一提到监控就想到:“是不是又要部署一大堆复杂软件?”其实未必。
对于一个小型业务系统,第一阶段真正重要的指标可能只有几个:
| 需要知道的事情 | 为什么重要 |
|---|---|
| 网站是否还能访问 | 最基本的 Availability |
| 后端是否持续报错 | 在客户反馈之前发现异常 |
| 数据库连接是否接近耗尽 | 提前发现资源压力 |
| 备份是否成功 | 避免真正需要恢复时才发现没有备份 |
| 登录失败率是否突然升高 | 发现认证或攻击异常 |
| 关键任务是否执行成功 | 避免后台任务“静默失败” |
这些指标甚至不一定需要自己从头造监控平台。市面上已经有很多成熟工具可以完成基础的日志收集、健康检查和告警。真正重要的并不是用了哪一个品牌,而是:告警响了以后,有没有人看?
云服务器有人维护,不等于你的应用有人维护
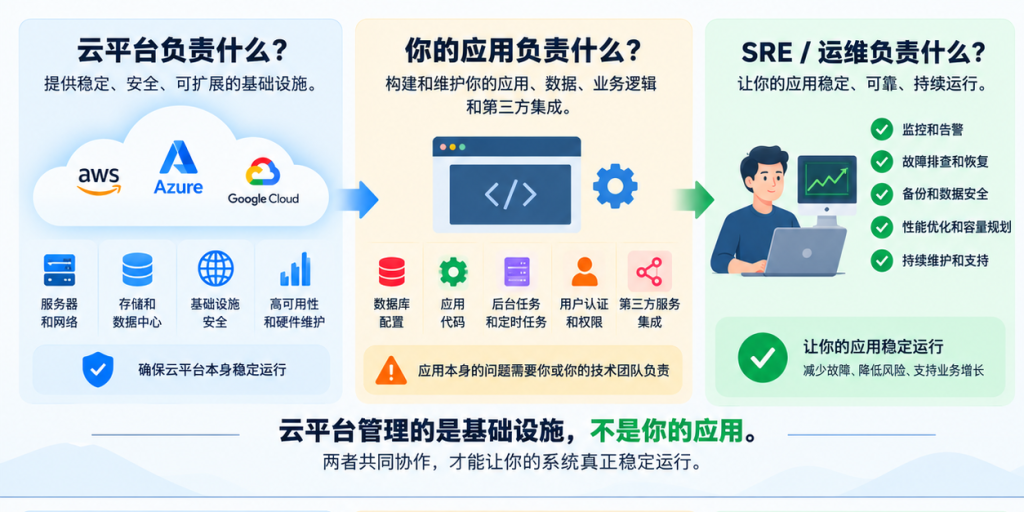
现在很多企业都把服务器放在 AWS、Azure、Supabase、Vercel 或其他云平台。于是很容易产生一种错觉:“我们的系统已经托管在大公司那里,所以应该挺安全的。”
但云厂商负责的是他们提供的基础设施。他们不会替你判断:你的后台任务是不是开了太多并发;你的应用是不是在数据库失败以后无限重试;你的备份任务是不是和业务争抢资源;你的登录接口是不是突然出现异常流量;你的某次发布是不是把业务逻辑改坏了。这些仍然属于你的应用本身。
可以把它理解成租办公室。物业负责电梯、水电、公共区域。但他们不会帮你管理公司的客户资料、员工流程和业务系统。云厂商负责平台。你的技术团队仍然需要负责你的应用。
小企业需要的,是“合适规模”的运维
写到这里,并不是想说每一家小企业都应该招聘三名 DevOps、搭 Kubernetes、搞十几个环境、做 24×7 三班倒。这显然是另一个极端。
一个刚上线的 MVP,也许只需要:健康检查、基本日志、数据库监控、每日备份、故障告警。业务开始增长以后,再增加:限流、服务降级、自动恢复、容量规划、更完整的 tracing。再往后,如果系统真的发展到需要专职团队,再建立内部 SRE 或 Platform Team。
正确的运维不是一步到位。它应该随着业务风险一起增长。这和软件架构本身其实是一样的。不要提前解决不存在的问题。但已经真实存在的问题,也不要一直假装看不见。
没有运维 vs 外包运维 vs 全职工程师
对于很多小企业来说,真正需要比较的其实不是:“要不要运维?”而是:“需要多少运维?”
| 方案 | 优点 | 主要问题 | 适合阶段 |
|---|---|---|---|
| 完全没有运维 | 几乎没有直接成本 | 出问题靠客户发现,风险不可控 | 原型、内部 Demo |
| Snowsy SRE 运维服务 | 按实际业务规模投入,有技术人员持续关注 | 不适合需要全天候内部团队的大型系统 | 小企业、MVP、早期 SaaS |
| 全职 DevOps / SRE | 深度参与业务,响应能力强 | 工资、Super、招聘和管理成本高 | 已有稳定规模的技术团队 |
很多小公司真正需要的,其实是中间这一档。系统已经重要到不能“坏了再说”。但又没有重要到值得为了它单独招聘一名全职工程师。
Snowsy SRE 运维服务:系统不需要永远不坏,但不能一直裸奔
Snowsy 提供面向小企业和创业项目的 SRE / 系统运维服务。即使你现在并不需要开发新功能,我们也可以协助处理:应用与数据库监控、日志和告警、备份检查、故障排查、部署流程、Staging、容量规划、限流与服务降级,以及事故后的技术复盘。
我们的目标不是把一个每天几十个用户的小系统改造成 Google。而是在合理的预算下,让它至少做到:出问题,有人知道;真正出事故,有人处理;处理完以后,不只是重启,而是知道下一步应该改什么。
如果你的系统目前还是:“服务器能打开就算正常,挂了等客户告诉我们。”那么也许并不需要立刻招聘一个全职技术团队。但确实值得开始考虑:是不是应该有人帮你看着它了?