一个已经稳定运行数月的 SEO 系统,在一次内容扩容后出现 Google Search Console impressions 明显下降。最终排查发现,问题并不在 SEO 内容本身,而在 Sitemap 生成链路中的数据库访问方式。
很多生产环境里的性能问题,并不会在上线第一天就暴露。它们往往潜伏在代码深处,等到数据量跨过某个临界点,才突然变成“系统坏了”。这个案例正是如此:客户自建的 SEO 内容系统已经平稳运行数月,前台页面正常、后台可用,直到批量导入新内容后,Search Console 的 impressions 开始明显下滑。表面上看像是典型的 SEO 问题,真正的根源却藏在技术链路里。
项目背景:数据增长后,Search Console 出现异常
客户拥有一套自建 SEO 内容系统,专门用来管理和生成大量搜索引擎落地页。系统此前已经运行数月,既有内容没有出现明显故障,前台访问与后台操作都保持正常。
近期客户开始批量导入一批新的 SEO 内容。导入完成后不久,Google Search Console 中的 Search Impressions 出现明显下降。第一眼很容易被归类为常见 SEO 问题:算法更新、新内容未被及时索引、页面质量不足、关键词表现波动,或者 Google 抓取频率下降。
但这一次,真正的问题并不在内容本身。在检查网站技术 SEO 基础设施时,我们发现了一个更直接的异常:sitemap.xml 已经开始出现请求超时。
为什么 Sitemap 超时值得优先处理
Sitemap 可以理解为网站提供给搜索引擎的“页面清单”。对于拥有大量动态页面的网站,它通常不是人工维护,而是由后端程序从数据库读取页面信息后动态生成 XML。
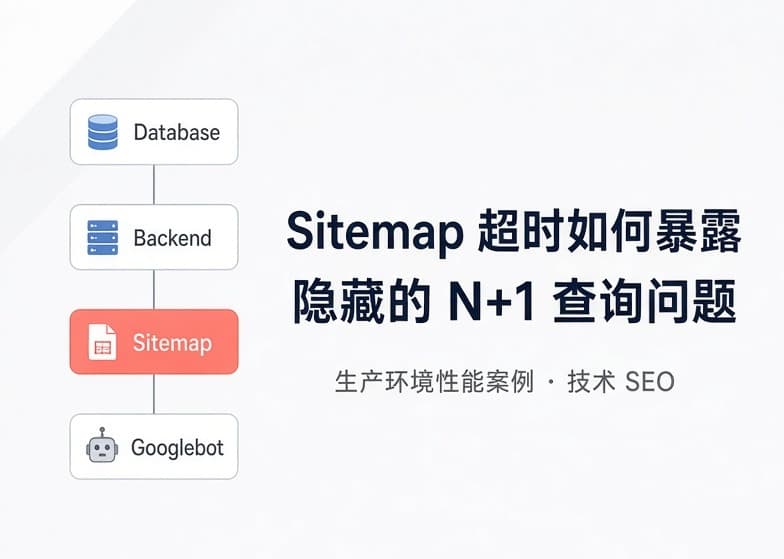
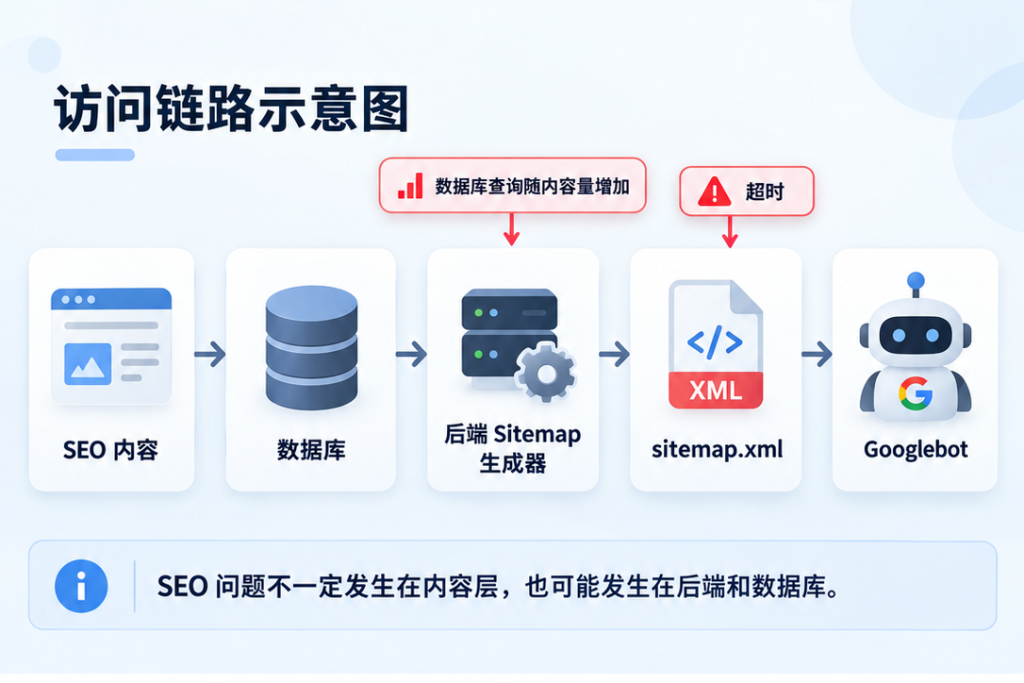
整条链路大致如下:数据库 → 后端读取 SEO 页面 → 生成 Sitemap → Googlebot 访问 → 搜索引擎发现并重新抓取页面。
普通用户几乎不会主动打开 sitemap.xml。这意味着一个现实问题:网站首页能正常打开,并不代表 Googlebot 使用的技术入口也正常。如果 Sitemap 长时间超时,搜索引擎发现新页面、重新访问已有页面的效率都会受到影响。
需要说明的是,Sitemap 超时并不能单独证明 Search Impressions 的全部下降都由此造成。Google 搜索表现还会受到内容质量、索引状态、排名变化、搜索需求以及抓取策略等多种因素影响。但在本案例中,Sitemap 已经出现明确的技术故障,因此必须优先排查。
根因定位:隐藏在 Sitemap 后面的 N+1
发现 Sitemap 超时后,我们没有直接修改 Timeout 时间。Timeout 通常只是结果,真正要解决的问题是:为什么原本可以正常生成的 Sitemap,现在突然需要这么长时间?
继续检查后端代码后,我们发现了一类典型问题:N+1 数据库查询。
假设 Sitemap 需要生成 1,000 个页面。合理的方式是通过一次或少量几次查询,将所需数据批量取出。但存在 N+1 时,逻辑会变成:先查询一次取得 1,000 个页面,然后处理第一个页面时再查一次数据库,处理第二个页面时再查一次,一直重复到第 1,000 个页面。结果是 1 次初始查询 + 1,000 次额外查询 = 1,001 次查询。
数据量增加后,问题会迅速放大。
| 页面数量 | 查询次数示意 |
|---|---|
| 20 | 21 |
| 100 | 101 |
| 1,000 | 1,001 |
| 5,000 | 5,001 |
这里的数字只是为了说明 N+1 的增长模式。实际项目中,如果每个 SEO 页面还需要继续读取分类、Metadata、语言版本或其他关联数据,查询数量还可能更多。
为什么这个问题运行几个月以后才出现
这个案例最有价值的地方,其实不是“N+1”本身,而是:问题很可能从第一天就存在。只是系统刚上线时,数据量还不够大。
比如只有 20 条数据时,大约 21 次查询。即使实现方式并不理想,服务器也可能很快完成,用户感觉不到问题,开发环境里也不一定能发现。
随着数据量不断增加——几十、几百、上千、几千——查询数量和处理时间同步增长。最终系统跨过了某个性能临界点。最初可能只需要 300ms,后来变成 1 秒、3 秒,最终超过应用服务器、反向代理或其他组件设置的最大等待时间。
从外部看,就像“为什么这个功能突然坏了?”但从工程角度看,故障出现的时间并不等于问题产生的时间。问题可能早就存在,只是最近的数据增长把它暴露出来了。
系统可以正常运行几个月,并不代表代码里没有问题。有些问题只是在等待数据量变大。
我们如何优化:先解决根因,再减少重复工作
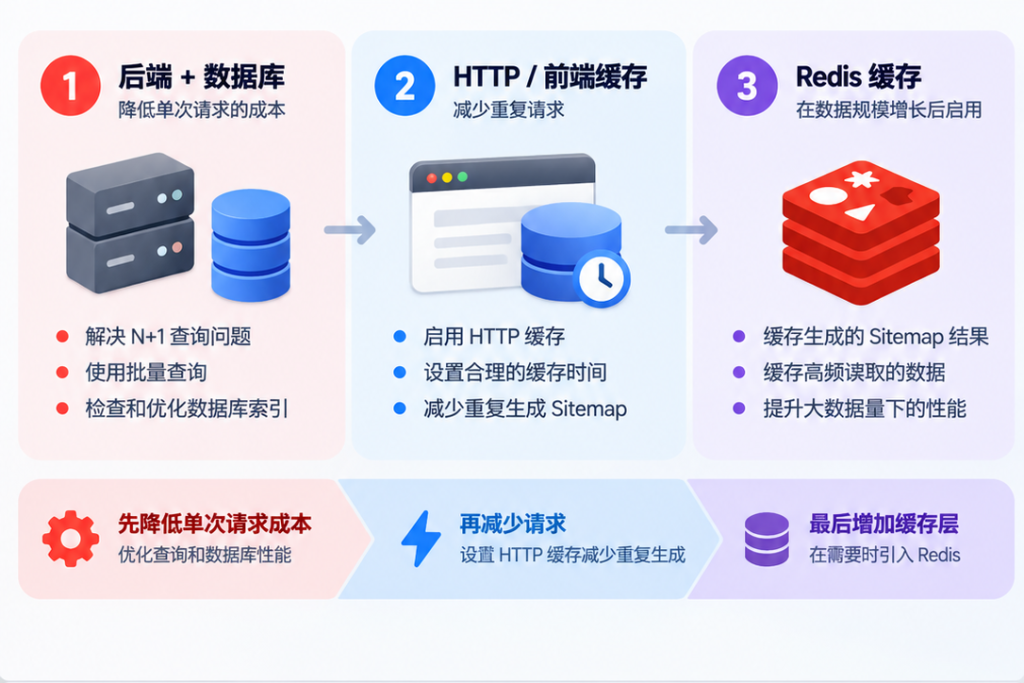
确认问题后,我们没有只对 Sitemap 做一个一次性修补。整个优化分成三层:后端与数据库查询优化、前端和 HTTP 缓存策略调整、接入客户已有 Redis 体系作为下一阶段扩展能力。目标不是“让 Sitemap 今天能打开”,而是让这条数据链路在未来内容继续增长时,仍然有扩展空间。
后端优化:通过代码和数据库分析定位问题
第一步是先确认问题到底发生在哪里。我们重新检查了后端的数据读取逻辑,包括查询次数、单次查询耗时、是否存在循环查询、是否重复读取相同关联数据、是否读取了不必要的字段,以及查询是否有效使用索引。
同时结合数据库自身的分析能力检查真实执行情况,例如通过 ANALYZE、执行计划、索引情况和实际查询表现,确认真正的性能瓶颈。这一点很重要,因为性能问题不一定全部来自 N+1,还可能来自缺少索引、JOIN 条件不合理、查询字段过多、一次读取数据量过大,或查询条件无法有效利用索引。
因此我们没有直接选择“加缓存”或“升级服务器”,而是先回答一个更基本的问题:数据库到底在做什么?在定位完成后,针对数据访问逻辑进行了调整,包括减少循环中的重复查询、批量读取所需数据,以及重新检查查询与索引设计。
前端与 HTTP 层:减少不必要的重复计算
后端查询优化完成后,我们同时检查了前端和 HTTP 层的缓存策略。Sitemap 和部分 SEO 数据并不是每一次请求都必须重新计算。如果内容更新频率有限,但每一次 Googlebot 请求都完整触发“读取数据库 → 整理数据 → 生成 XML → 返回结果”,系统实际上在反复执行相同工作。
因此我们重新调整了缓存设置,让短时间内重复访问相同资源时,可以尽可能复用已有结果。
| 优化前 | 优化后 |
|---|---|
| 每次请求重新计算 | 合理时间内复用结果 |
| 重复访问持续打到后端 | 部分请求直接使用缓存 |
| 数据库承担大量重复工作 | 数据库更多处理真实变化 |
| 流量增长直接放大后端成本 | 缓存吸收部分重复访问 |
当然,缓存也不是越长越好。如果 Sitemap 缓存时间太长,新页面可能无法及时反映出来;如果完全没有缓存,又会产生大量重复计算。因此需要在数据新鲜度与系统性能之间取得平衡。
Redis:现在不强行使用,但为更大规模预留能力
客户原有系统中已经存在 Redis 缓存基础设施。在完成后端和 HTTP 缓存优化以后,目前的数据规模还不需要依赖 Redis 才能正常工作。因此我们没有为了“架构看起来更高级”而直接把所有数据都塞进 Redis,这样反而会引入新的复杂度,例如缓存失效、数据一致性、Cache Miss、更新同步和缓存键设计。
但由于客户已经拥有现成 Redis 系统,因此我们将它纳入后续扩展方案。如果 SEO 数据量继续增长,可以考虑缓存 Sitemap 生成结果、SEO 页面列表、页面 Metadata、高频读取但低频修改的数据,以及部分聚合结果。
为什么我们没有选择直接升级服务器
面对 Sitemap 超时,最简单的处理方法其实很多:增加 CPU、增加 RAM、提升数据库规格、把 Timeout 从 10 秒调成 30 秒,或提高反向代理等待时间。这些方式有时确实能暂时缓解问题,但它们没有改变系统的增长关系。
如果原来的逻辑是 1,000 个页面对应 1,001 次查询,升级服务器以后也许 1,000 次查询可以跑得更快。但以后变成 10,000 个页面对应 10,001 次查询时,问题依然会回来。
所以我们更关心的是:随着数据量增长,系统成本是不是也在不合理地同步增长。这也是为什么代码优化和缓存设计比单纯堆服务器更重要。服务器升级提高的是“上限”,查询优化改变的是“增长方式”。
这个案例对快速开发和 Vibe Coding 的启示
这个项目并不是为了证明快速开发不可靠。恰恰相反,快速搭建 Demo、MVP、CMS、管理后台、落地页、SEO 页面或支付流程,本身具有很高的价值——它能让一个想法更快变成真实产品。
但快速生成代码以后,有一个常见误区:功能能运行,就被等同于系统已经完成。
| Demo 能验证的事情 | Demo 通常不能验证的事情 |
|---|---|
| 页面可以打开 | 10,000 条数据时是否还能打开 |
| Sitemap 能生成 | 数千页面后是否仍能生成 |
| 数据可以保存 | 数据量增长后查询是否仍然合理 |
| API 可以返回 | 第三方变慢时系统会怎样 |
| 后台可以使用 | 业务扩大后性能是否还能接受 |
这也是为什么很多系统并不会在上线第一周出问题。它们可能运行几个月,直到数据第一次快速增长、用户数量增加、SEO 页面大量扩展、搜索引擎开始频繁访问,或后台任务处理的数据越来越多时,问题才真正显现出来。
工程结论与下一步
这个案例最终说明的是一个非常典型的生产环境问题:“现在能跑”并不等于“以后也能跑”。
从客户角度看,这套系统已经稳定运行了几个月;从代码角度看,性能问题可能从第一天就已经存在;从业务角度看,一次正常的数据增长,最终触发了一个隐藏的系统瓶颈。
因此,当一个产品已经进入真实运营阶段以后,技术检查不应该只关注“现在有没有 Bug”,还需要继续问:如果数据继续增长会怎样?如果用户增加会怎样?如果搜索引擎访问频率增加会怎样?哪些问题只是暂时还没有达到触发条件?
Demo 证明的是功能可以实现。Production Engineering 要证明的是,系统能够随着业务继续运行。
项目信息
| 项目维度 | 内容 |
|---|---|
| 项目类型 | SEO Platform / Web Application |
| 问题类型 | Performance / Technical SEO / Database |
| 主要症状 | Sitemap Timeout |
| 根因 | N+1 Database Queries |
| 触发条件 | SEO 数据量明显增长 |
| 影响范围 | Sitemap 可用性、搜索引擎抓取链路 |
| 优化方式 | 后端查询优化、数据库分析、HTTP 缓存、Redis 扩展预留 |
你的系统也已经运行几个月了吗?很多生产环境问题并不会在上线当天出现。它们通常会等到数据变多、用户增长、SEO 页面扩展、业务开始真正跑起来以后才显现。
如果你的系统已经上线,但不确定数据库查询、缓存、SEO 基础设施或后端性能是否能够支撑下一阶段增长,Snowsy 可以帮助你进行一次 Production Health Check。我们关注的不只是“现在能不能运行”,而是“业务继续增长以后还能不能运行”。
本案例基于 Snowsy 实际项目经验整理。为保护客户隐私,客户名称、业务数据、系统规模及部分技术实现已经匿名化或抽象处理。案例内容用于展示问题诊断与工程分析方法,不代表 Sitemap 故障一定会直接导致特定 SEO 排名或流量变化。